运维管理30 分钟阅读
Oracle ASM 管理与维护 100 条命令
ASM 把数据文件、控制文件、联机日志和归档日志统一放进磁盘组,数据库看到的是 `+DATA` 这样的文件名,底层磁盘、镜像和条带由 ASM 负责。空间不足只是最直观的问题;成员盘离线、failure group 分布不合理、重平衡卡住,同样可能影响数据库。
2026年9月16日阅读—点赞—收藏—
dba100oraclescenario
100 条命令系列文章专栏
ASM 把数据文件、控制文件、联机日志和归档日志统一放进磁盘组,数据库看到的是 `+DATA` 这样的文件名,底层磁盘、镜像和条带由 ASM 负责。空间不足只是最直观的问题;成员盘离线、failure group 分布不合理、重平衡卡住,同样可能影响数据库。
ASM 把数据文件、控制文件、联机日志和归档日志统一放进磁盘组,数据库看到的是 +DATA 这样的文件名,底层磁盘、镜像和条带由 ASM 负责。空间不足只是最直观的问题;成员盘离线、failure group 分布不合理、重平衡卡住,同样可能影响数据库。
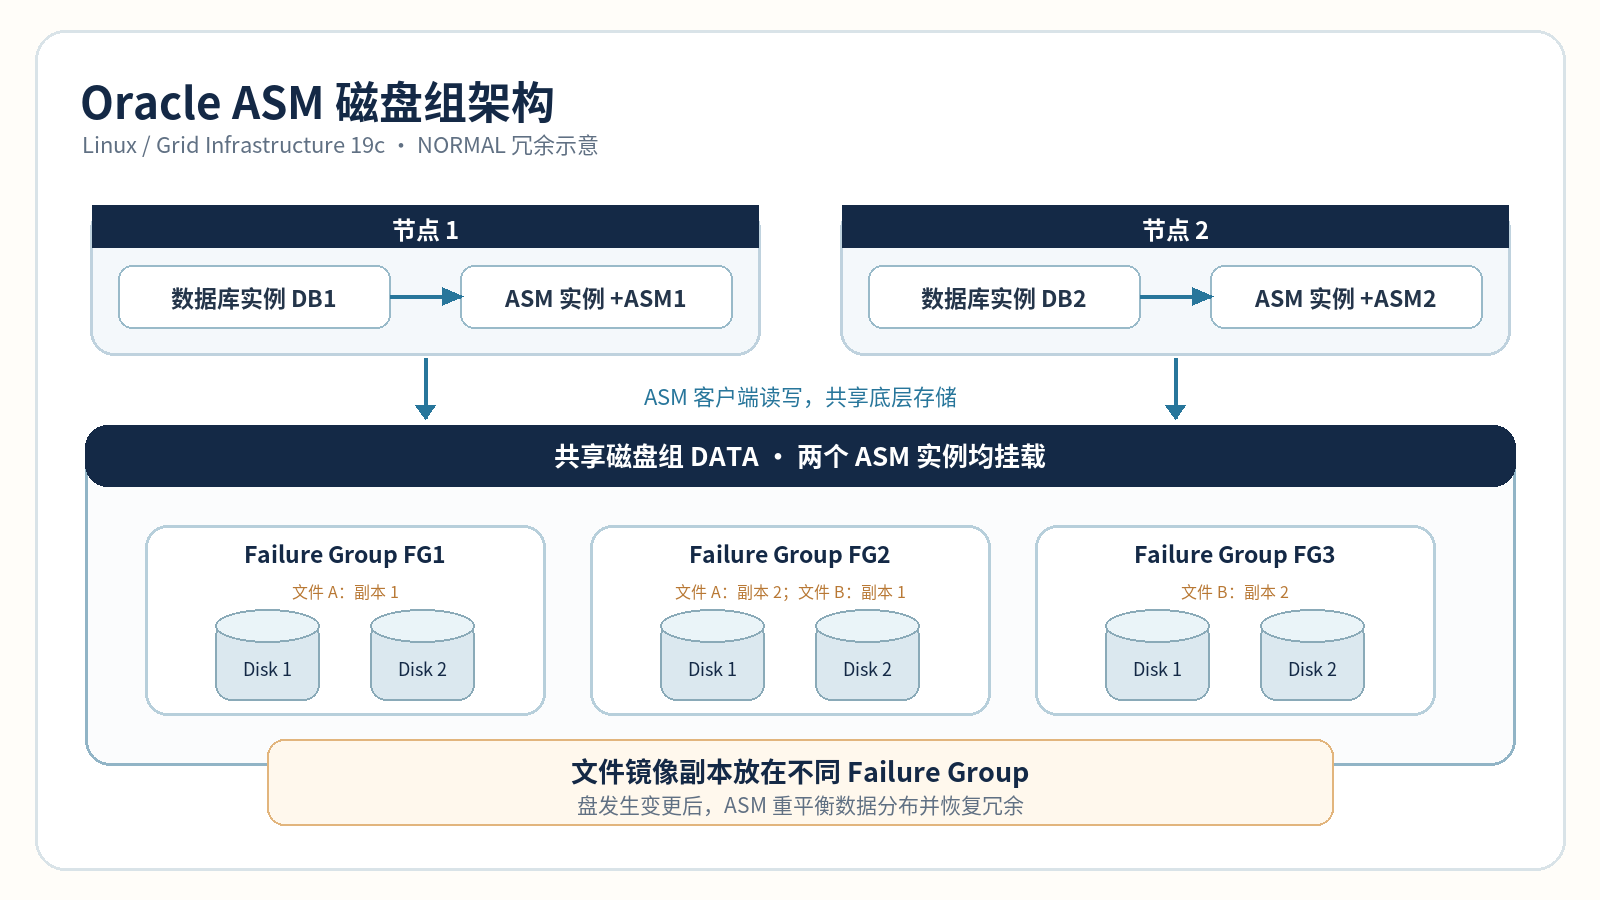 Oracle ASM 磁盘组架构示意图
这 100 条命令覆盖磁盘组容量、成员盘、镜像、文件、I/O、重平衡和磁盘维护。日常巡检先看磁盘组与成员盘状态,故障时再沿着数据库文件、ASM 文件和物理设备逐层定位。建议收藏,做扩容、换盘或处理 ASM 告警时可以直接对照使用。
示例基于 Linux 和 Grid Infrastructure 19c。DATA、磁盘名和 ASM 实例名需要按现场替换;ASMCMD、SRVCTL 和 ADRCI 使用 Grid Infrastructure 软件属主,SQL 以 SYSASM 连接 ASM。涉及加盘、剔盘和上下线的操作集中在最后,执行前先确认所有节点都能看到同一设备。
先看磁盘组有没有挂载,再核对名称。这个输出不会替你判断各节点是否一致;遇到 RAC 节点间状态差异,继续看第 3 条。
Type 是磁盘组冗余方式,Free_MB 是未使用物理容量。NORMAL、HIGH 冗余组要重点看 Usable_file_MB,不能用 Free_MB 直接估算还能写入多少文件;FLEX、EXTEND 组另按文件组和配额检查。
-g 从集群视图取数,输出带 INST_ID。某个节点没有挂上磁盘组时,先查该节点的磁盘发现路径和 ASM 日志,不要只凭健康节点的 lsdg 认为全群正常。
这里检查的是 Clusterware 管理的 ASM 实例,不只是磁盘组是否可见。某个节点 ASM 未运行时,先处理资源状态和实例日志,再判断该节点为什么没有挂载磁盘组。
V$ASM_DISKGROUP_STAT 不做每次磁盘发现,适合重复巡检;刚接入但尚未发现的新磁盘组不一定出现在这里。需要确认新组时,再用带发现能力的视图或 lsdg --discovery。
REQUIRED_MIRROR_FREE_MB 是恢复冗余要保留的容量;在 NORMAL、HIGH 冗余组中,USABLE_FILE_MB 已计入镜像要求,更接近还能安全放入新文件的空间。FLEX、EXTEND 组这两列为 0 时表示不提供该值,不能解读为没有可用空间。磁盘组未挂载时先确认状态。
COMPATIBILITY 约束能挂载该组的 ASM 版本,DATABASE_COMPATIBILITY 约束能使用组中文件的数据库版本。升级兼容属性前要核对所有连接的数据库实例,不能仅看当前节点软件版本。
第一条确认是否启用 Flex ASM,第二条确认集群处于正常、滚动补丁还是滚动升级状态。维护状态不同,允许执行的实例和磁盘操作也不同。
DB_Name 和 Instance_Name 能把磁盘组对应到实际客户端。准备卸载磁盘组时先看这里;若还有数据库、OCR 或 CSS 客户端连接,不要把磁盘组当成无人使用。
STATUS 为 CONNECTED 是活跃连接,BROKEN 指连接异常结束。GROUP_NUMBER = 0 的客户端可能连接了 ASM 但尚未使用磁盘组,左连接可保留这类记录;集群 OCR、CSS 客户端也可能出现在结果里。
先确认 ASM 使用的是哪些设备路径。多路径环境要看 ASM 最终采用的设备别名,不要把操作系统里看到的每条路径都当成独立 ASM 磁盘。
-p 同时列出 MOUNT_STATUS、HEADER_STATUS、MODE_STATUS 和 STATE。在 ASM 实例中,已挂载磁盘通常是 CACHED / MEMBER / ONLINE / NORMAL;其中一个异常时,记下磁盘号和路径继续查。
-k 会把 TOTAL_MB、FREE_MB、OS_MB 和 FAILGROUP 放在一起。加盘或扩盘后可先核对 ASM 看见的容量;镜像组还要看数据是否分散在预期的 failure group。
这是当前 ASM 实例的视角,适合找本节点异常盘。结果为空只说明这个节点的缓存状态未见异常;节点间可见性问题仍要看第 18 条。
SYNCING 不是普通联机,它表示 stale 数据在回同步;HUNG 可能是剔盘时容量不足。REPAIR_TIMER 单位为秒,仍要结合告警日志和冗余状态判断是否来得及修复。
CANDIDATE、PROVISIONED 和 FORMER 可作为加盘候选线索;FOREIGN 或 CONFLICT 要先查设备来源,不要使用 FORCE 硬加。V$ASM_DISK 每次查询都会发现磁盘,成本高于 V$ASM_DISK_STAT。
这里也会触发发现,适合加盘前的单次确认。候选状态只是 ASM 磁头判断;真正加盘前还要核对设备标识、大小、属主权限和所有集群节点的可见性。
-M 专门列出在部分活动实例上可见、在另一些实例上不可见的磁盘。这类盘放进共享磁盘组会导致部分节点挂载失败,应先查存储映射和多路径配置。
扩盘后若 OS_MB 已变而 TOTAL_MB 尚未变化,说明 ASM 容量未同步到新值。不要只看存储侧“扩容成功”;确认每个节点都看到相同大小后,再安排 ASM 磁盘 resize。
-t 显示 REPAIR_TIMER、创建和挂载时间。盘掉线后 REPAIR_TIMER 会倒计时;先确认冗余副本、存储故障和恢复时间,再决定是否需要在线修复或走换盘流程。
Failure group 应按可能一起故障的硬件边界划分。只看磁盘数量不够,还要看各组容量;镜像副本要落在不同 failure group。
QUORUM 组与存业务数据的 REGULAR 组用途不同。核算业务文件空间和容灾边界时,不要把 quorum 盘当成同等的数据镜像容量。
这能说明 DATA 内哪些盘含 voting file。涉及这些盘的下线、替换或共享存储维护,要连同 GI 的投票盘状态一起核对,不能只看数据库能否连接。
单个盘掉线与同一 failure group 内多盘同时掉线,对冗余的影响不一样。结果出现多盘时,先排查共同的存储映射、电源或链路故障。
NORMAL 冗余组在满足条件时,预留镜像恢复容量与最大普通 failure group 的大小有关;HIGH 冗余则可能需要考虑两个最大组。对照第 6 条的 REQUIRED_MIRROR_FREE_MB,不要直接套单一公式到 FLEX、EXTEND 组。
某组容量明显偏小或空闲率明显低时,即使整个磁盘组还有 FREE_MB,文件分配也可能受限制。确认是否刚加盘、刚剔盘或重平衡未结束,再判断要不要扩容。
PREFERRED_READ = 'Y' 表示该盘属于首选读 failure group;U 表示磁盘组未设置此功能。读 I/O 倾斜时可以先核对这个配置,不能只按磁盘个数平均估算读量。
磁盘组 TYPE 不等于每个文件的冗余级别;同组内文件可能是 MIRROR、HIGH 或 UNPROT。SPACE 是已分配字节,不等于文件逻辑长度 BYTES。这个查询看配置和占用,不证明当前每个 extent 的副本都健康。
FLEX 组调整文件组冗余后,REMIRROR = 'Y' 说明文件仍需要重平衡完成镜像调整。它不是通用“副本损坏”字段;普通磁盘组不要照搬此判断。
配置值可能写成小时或分钟;掉线盘实际剩余时间仍看 REPAIR_TIMER。准备更换盘时,先把修复窗口、存储侧恢复预计时间和冗余状态对齐。
Used_MB 不含镜像,Mirror_used_MB 含镜像。这里按 ASM 目录递归统计文件,适合先找占用量;它不是文件系统 du,也不表示数据库对象真正使用了多少数据块。
ORCL 改成实际 ASM 目录名。主库、备库或不同 DB_UNIQUE_NAME 可能各占一个目录;先对目录再核对数据库归属,不要仅凭目录名删除文件。
Bytes 是文件逻辑大小,Space 是 ASM 已分配大小。NORMAL 冗余下两者差别可能明显;确定要扩容多少时,还得回到磁盘组可安全使用空间和数据文件增长上限。
find --type 可按 ASM 文件类型查完整路径。结果要与数据库 CONTROL_FILES 参数对照;ASM 目录里有旧文件,不代表当前实例仍在使用。
输出包含 DB_Name、Instance_Name 和 ASM 路径。准备维护或卸载磁盘组时,比只看目录列表更接近当前使用情况;它列的是本节点客户端,不能代替全群检查。
先看空间主要落在 DATAFILE、BACKUPSET、ARCHIVELOG 还是 FLASHBACK。若备份和归档占了大头,清理由 RMAN 或数据库保留策略处理,别在 ASM 里直接 rm。
ASM 文件号和 incarnation 用来定位对象,输出本身没有完整别名路径。进一步到数据库控制文件视图或 ASMCMD 目录核对文件归属,不能见“大文件”就判断可以删除。
新旧盘大小不同、加盘未重平衡或剔盘未完成,都可能造成分布不匀。整组 FREE_MB 还有空间,也可能因某个盘接近满而写入受阻。
这里的阈值单位是 MB,要按单盘容量设,不能让 100 GB 和 10 TB 的盘共用同一个绝对值。若盘状态还在 DROPPING,先看重平衡和剩余空间是否足够完成搬迁。
lsod 列的是打开的 ASM 磁盘及相关进程,与第 35 条的文件级 lsof 不同。RBAL 执行重平衡时可能同一磁盘显示不止一次,不能按返回行数计算磁盘数量。
加上 5 秒刷新间隔后,读写量显示的是两次采样之间的差值;不加间隔则是累计量。盘之间要按相近容量和相同采样时段比较,单次读写量偏高并不能证明盘故障。
--io 把读写字节数切换成 I/O 次数。同样的吞吐量下,小块随机 I/O 与大块顺序 I/O 的次数差很多;排查某盘是否被打满时,字节数和次数最好一起看。
读写量、错误数和累计时间放在一张结果里,先找异常盘,再做两次采样比较增量。累计时间高可能只是运行时间长;只有错误持续增长或同类磁盘延迟明显偏高时,才值得继续查存储路径。
重点核对 ASM Home、监听、实例数量、SPFILE 和密码文件位置。环境切换或补丁后如果资源仍指向旧目录,ASM 可能能手工启动,却无法由 Clusterware 正常管理。
先确定当前节点和 ASM 实例对应的 ADR home,再查看告警。ASM 启动失败时 ADR 仍在数据库之外可用,比只在 $GRID_HOME/log 下猜文件位置可靠。
把 homepath 换成第 45 条查到的实际值。磁盘离线、发现路径变化、重平衡失败和元数据错误都会写入 ASM alert;保存完整时间和错误栈,不要只截最后一行 ORA 错误。
V$ASM_DISK_IOSTAT 按客户端列磁盘计数。一个磁盘组服务多套库时,用它区分数据库实例的 I/O;在 ASM 实例查询可看到客户端行,从数据库实例查询则只显示该实例的行。
保存一次结果再复查,确认哪个客户端、哪个 disk number 的错误在增长。客户端计数与盘级计数的口径不同,不能把两张视图的数值直接相减;定位到盘后再查设备路径。
这里是累计 I/O 时间除以累计次数,只能粗看盘间差异。TIMED_STATISTICS=FALSE 时耗时为 0;排查当前变慢,应取两次采样的时间和次数增量,再与数据库等待、存储延迟对照。
超时计数即使不再增长也会保留,关键看当前 MODE_STATUS、STATE 和修复倒计时。OFFLINE 或 SYNCING 时先查镜像副本和重同步进度,别把一条历史超时当成重新加盘的理由。
lsop 对应本节点 V$ASM_OPERATION。WAIT 表示该 pass 当前没有运行,RUN 才是正在执行;FLEX 组还可能显示 RESYNC 等阶段。没看到运行行,也要检查其他 ASM 节点。
19c 应看 PASS,不要只看旧的 OPERATION 列。RESYNC 是盘重新上线后的数据同步,REBUILD 是强制移除盘后的冗余修复;两者与均衡数据分布的 REBALANCE 不是同一件事。
POWER 是请求值,ACTUAL 是实际分配值。调高 power 不保证线性提速,ASM 会受资源约束;业务高峰前先确认当前 I/O 和剩余修复窗口,再决定是否调整。
EST_WORK 以 allocation unit 计,EST_MINUTES 是估计剩余分钟数。刚进入 EST 或数据量仍在变化时,预计时间可能跳动;排班别把它当成精确完成时刻。
ERRS 表示该阶段因错误停止。先保留错误码并查 ASM alert 日志、盘状态和空间,再评估重试;盲目重复 REBALANCE 可能继续卡在同一个坏盘或容量问题上。
RAC 中重平衡可能由另一 ASM 实例承担。GV$ 把节点一起列出,避免本节点 lsop 为空就误判为没有搬迁;同一组的 pass 应按 INST_ID 看。
DROPPING 还在搬迁,不能马上把设备从操作系统撤走;HUNG 通常提示没有足够空间搬完。FORCING 则是跳过迁移依赖其他副本恢复,须同时核查副本和重建阶段。
-g 汇总各 ASM 节点的磁盘组视图。Rebal=Y 说明当前有重平衡;各节点都应能正常挂载 DATA。若某节点视图状态不同,先处理磁盘发现或挂载问题,再谈调速。
未在 ALTER DISKGROUP 指定 POWER 时,重平衡使用 ASM_POWER_LIMIT 的默认值。它是 ASM 实例参数,检查集群时别只看一个节点;本条只读取当前设置。
在采样间隔内同时看 I/O 次数和累计耗时增量,再与第 52 条的 pass、power 对上时间。重平衡会占用盘 I/O,但单看这一屏无法把每笔 I/O 精确归属业务或 RBAL;若业务等待也升高,应进一步查数据库与存储侧。
先核对 compatible.asm、compatible.rdbms 和需要时的 compatible.advm。升级 GI 后属性不会自动变成新版本;提高兼容级别前还要查仍连接这个组的低版本数据库。
密码文件通常由 Clusterware 管理并存放在 ASM 中。节点扩容、Grid Home 切换或认证异常时先确认实际位置,不要在本地文件系统另建一份同名密码文件覆盖现有配置。
集群节点补丁不一致可能引起行为差异。这里快速查看当前 Grid Home 已应用的补丁;正式核对仍要结合各节点 opatch lsinventory 和补丁实施记录。
AU 大小影响 ASM 文件分配单位,物理和逻辑扇区大小要与新盘匹配。BLOCK_SIZE 是 ASM 元数据块大小。这里读取的是磁盘组设置;新盘接入前还要查设备报告值,不能用组属性推断所有候选盘都兼容。
模板决定新文件创建时默认的镜像与条带设置。系统模板也可能被调整过;不要把 NORMAL 磁盘组和 DATAFILE 一律画等号,先看实际模板再确认文件的实际冗余。
REDUNDANCY 是模板要求,STRIPE 是条带方式。已有文件不会因模板调整而自动全部重写;查现存文件是否符合预期,还要回到 V$ASM_FILE 的文件属性。
控制文件、日志文件的模板可能与数据文件不同。SYSTEM=Y 表示系统模板,不代表配置一定是默认值;恢复或搬迁前要确认目标组的新文件落盘策略。
文件组只适用于兼容属性达到要求的磁盘组,默认文件组不会显示。FLEX 组做容量和冗余判断时,要把客户端、文件组和 quota group 对上,不能只看整个磁盘组的空闲空间。
提高 compatible.rdbms 前,逐个确认仍使用 DATA 的数据库 COMPATIBLE 设置;客户端软件版本也要与方案一起检查。此查询反映当前连接者,不覆盖暂时停机但仍依赖该组的库。
属性属于磁盘组,各节点正常挂载后应读到同一组设置。若某节点没有行,先查它是否挂载 DATA、是否能发现成员盘;不能直接判断成属性丢失。
V$DATAFILE 记录控制文件中的当前数据文件名称。ASM 目录里看到的旧别名不一定属于这套库;核对数据文件归属时,先以目标数据库控制文件为准。
临时文件也可能在 FRA 或其他磁盘组。目录中的 TEMPFILE 只能说明文件类型,不能说明它仍在当前数据库配置里;异常遗留文件先查控制文件记录。
和第 34 条的 ASM 搜索结果对照。V$CONTROLFILE 列的是数据库当前配置,搜索命中的历史控制文件副本不能凭文件名直接替代现用文件。
TYPE 区分 ONLINE 和 STANDBY,STATUS=INVALID 提示成员不可访问。仅查看 ASM ONLINELOG 目录容易漏掉其他组和 FRA 中的成员,数据库视图更适合核对现用配置。
归档记录可能包含已经由 RMAN 删除的文件,列表存在不代表文件仍能读取。核对备份链或清理时,再看 DELETED、备份记录及实际存储状态。
ORCL 换成实际 DB_UNIQUE_NAME。此命令只列本节点客户端打开的文件,适合把数据库名与 ASM 路径对上;RAC 全群文件归属还要逐节点查。
找出的只是 ASM 路径。备份集是否属于当前恢复链、是否已经过期,要以 RMAN 备份清单和控制文件记录为准,不能直接在 ASM 中删掉“旧日期”的文件。
文件号可能被重用,连接时必须同时带 incarnation。ALIAS_NAME 只是路径的一个名称片段,不能当完整 ASM 路径;需要完整路径时用 ASMCMD 目录逐层确认。
mapblk 给出指定块的 ASM 逻辑 extent、磁盘名、设备路径和偏移;镜像文件可返回多个副本。它适合定位某个坏块对应的设备,不能用一个块的位置推断整个文件只在这些盘上。
-l 看冗余和条带,-s 看空间。路径应先从数据库视图确认;ASM 文件的 Space 与数据库对象的已用数据块不是一个概念,不能据此判断表空间是否还能分配。
输出可能分别列 GPnP profile 和 ASM 参数中的 diskstring。加盘前要确认每个 ASM 节点都能发现同一设备,且路径不是多路径的重复入口;看到盘名不等于它可安全加入。
--candidate 只列 CANDIDATE,--discovery 会扫描新盘,适合加盘前的一次性检查。FORMER 或 PROVISIONED 不会自动出现在这份清单里;任何准备复用的盘,都要先核实来源和数据处理流程。
-M 专门列出只被部分活动 ASM 实例发现的盘。加盘、换盘前这里应先处理成空结果;否则某节点无法挂载磁盘组。这个检查不能代替操作系统层的设备 ID 和多路径映射确认。
这是加盘前的发现查询,V$ASM_DISK 会扫描磁盘,别做成高频巡检。OS_MB 与 TOTAL_MB 明显不符或扇区格式混杂时,先向存储侧核实;不要用 ALTER DISKGROUP ADD 试错。
NORMAL/HIGH 组不能只看 FREE_MB;新增业务文件和剔盘搬迁还要留出镜像恢复空间。FLEX/EXTEND 组的 USABLE_FILE_MB 可能为 0(未提供该估算),此时按文件组冗余和 failure group 分布另行评估。
剔盘会把数据迁到剩余盘,镜像副本还必须分散在不同 failure group。某个 failure group 过小或已满时,整组剩余空间看着充足也可能搬不完。
已有盘处于 OFFLINE、SYNCING、DROPPING 或 HUNG 时,先弄清原因和修复进度。不能在镜像尚未恢复时随手拿掉另一块盘,尤其要看两块盘是否在不同 failure group。
REPAIR_TIMER 的单位是秒,只在磁盘组挂载时推进。即使后来调大 disk_repair_time,已离线盘的原计时也不会自动延长;修盘计划应以当前盘的倒计时为准。
盘维护影响的是磁盘组服务的所有客户端,不只提交变更的那套库。GV$ 列当前连接的节点和实例;停机但仍使用 DATA 的库还要从配置和维护记录补查。
EST_WORK 是预计要搬迁的 allocation unit 数,不能直接换算成业务停顿时间。估算后还要确认剩余镜像空间、业务 I/O 和实际存储窗口;EXPLAIN WORK 不会真的剔盘。
先确认 grid 账号可写本地备份目录,并把文件复制到独立存储。该备份保存 ASM 配置元数据,不能代替 RMAN 数据备份。
加盘、改模板或大规模调整前留一份配置快照,方便对照别名、模板和属性。md_backup 文件需要单独保存与验证;它不包含数据文件内容。
这会修改磁盘组并触发重平衡。先完成第 81—89 条,确认设备唯一、各节点可见、空盘归属和 failure group;示例路径、盘名和 FG_NEW 均须按现场替换。
命令返回后盘可能仍处于 ADDING,重平衡也可能继续运行。下一条回读成员状态和搬迁阶段;不要把 SQL 返回成功当作已完成加盘。
确认 MEMBER、ONLINE,并检查它落入计划中的 failure group。还要看 V$ASM_OPERATION 直到搬迁完成,再核对各节点挂载和业务 I/O。
这会搬迁盘上的 extent,未完成前不得撤掉设备。先核对第 85—90 条的空间、镜像、工作量及其他节点状态;示例使用默认 NOFORCE,不写 FORCE。
默认异步返回,盘还在 DROPPING 时不能给存储侧释放 LUN。若变成 HUNG,先处理空间不足;不能靠强制剔盘掩盖搬迁失败。
实际设备路径须按第 94 条的盘名核对。等 HEADER_STATUS=FORMER,并确认重平衡没有未完成阶段后,才可按存储变更单释放;DROPPING 或仍为 MEMBER 都不能撤盘。
这会降低当前冗余;先确认另一副本可访问、没有第二块异常盘,并与存储人员确定修复时间。示例设置 2 小时后自动剔除,现场须按恢复能力调整。
离线后立即记录 REPAIR_TIMER,安排设备修复。超过窗口会被剔除;事后调大磁盘组 disk_repair_time 不会自动改掉这块盘已经开始的倒计时。
先由存储侧确认原设备和盘头未被复用,且修复计时未过期;否则应走重新加盘及数据恢复方案。
上线后可能进入 SYNCING,陈旧 extent 仍须重同步。等待 MODE_STATUS=ONLINE、STATE=NORMAL,并确认 RESYNC 阶段完成,再宣布冗余恢复。
这会改变当前搬迁速度。业务 I/O 已受到影响且恢复窗口允许延长时,先记录原 power 与剩余工作量,再经变更流程调整。
--modify 改正在运行的重平衡 power,不重新启动一个独立搬迁。执行后回读 POWER、ACTUAL 和业务等待;若正在修复故障盘,调慢会延长冗余降低时间。
此处只检查,不使用 --repair。检查可能占用 I/O,安排在有余量的维护窗口;发现错误先保留输出和 ASM alert 日志,再制定修复方案。
--repair 会写入修复元数据,不能因为检查报错就直接加上。先确认备份、故障盘状态和支持方案,必要时由 Oracle 支持指导下一步。
操作结束时各 ASM 节点应正常挂载 DATA,离线盘数与变更目标一致,容量不再异常下跌。还须复查成员盘状态、GV$ASM_OPERATION 和业务数据库连接;只有三边都对上,变更才算完成。
ASM 出现问题时,先确认影响的是磁盘组、成员盘还是单个文件,再核对 failure group、镜像空间和正在执行的重平衡。加盘、剔盘或重新上线完成后,要同时检查所有 ASM 节点、成员盘状态和数据库客户端;SQL 返回成功只是操作开始,状态全部回读正常才算结束。
 ORA100 DBA100 系列海报
更多场景命令收录在 ORA100 · DBA100:
微信里也可以搜索小程序 「三笠的百令册」。
1asmcmd ls -l +1asmcmd lsdg1asmcmd lsdg -g1srvctl status asm -detail -verbose1SELECT name, state, type, offline_disks, voting_files2FROM v$asm_diskgroup_stat3ORDER BY name;1SELECT name, total_mb, free_mb,2 required_mirror_free_mb, usable_file_mb3FROM v$asm_diskgroup_stat4WHERE name = 'DATA';1SELECT name, compatibility, database_compatibility,2 allocation_unit_size3FROM v$asm_diskgroup_stat4WHERE name = 'DATA';1asmcmd showclustermode2asmcmd showclusterstate1asmcmd lsct DATA1SELECT c.db_name, c.instance_name, c.group_number,2 g.name AS diskgroup_name, c.status,3 c.software_version, c.compatible_version4FROM v$asm_client c5LEFT JOIN v$asm_diskgroup_stat g6 ON g.group_number = c.group_number7ORDER BY c.db_name, c.instance_name;1asmcmd lsdsk -G DATA1asmcmd lsdsk -p -G DATA1asmcmd lsdsk -k -G DATA1SELECT name, disk_number, path,2 mount_status, header_status, mode_status, state3FROM v$asm_disk_stat4WHERE group_number = (5 SELECT group_number6 FROM v$asm_diskgroup_stat7 WHERE name = 'DATA')8AND (mount_status <> 'CACHED'9 OR header_status <> 'MEMBER'10 OR mode_status <> 'ONLINE'11 OR state <> 'NORMAL')12ORDER BY disk_number;1SELECT name, path, mode_status, state, repair_timer2FROM v$asm_disk_stat3WHERE group_number = (4 SELECT group_number5 FROM v$asm_diskgroup_stat6 WHERE name = 'DATA')7AND (mode_status IN ('OFFLINE', 'SYNCING')8 OR state IN ('DROPPING', 'HUNG', 'FORCING'))9ORDER BY repair_timer, name;1-- 一次性磁盘发现查询,勿作为高频巡检2SELECT path, header_status, mount_status,3 os_mb, library4FROM v$asm_disk5WHERE header_status <> 'MEMBER'6ORDER BY header_status, path;1asmcmd lsdsk --candidate --discovery1asmcmd lsdsk -M -G DATA1SELECT name, path, os_mb, total_mb,2 os_mb - total_mb AS difference_mb3FROM v$asm_disk_stat4WHERE group_number = (5 SELECT group_number6 FROM v$asm_diskgroup_stat7 WHERE name = 'DATA')8ORDER BY ABS(os_mb - total_mb) DESC;1asmcmd lsdsk -t -G DATA1SELECT d.failgroup, COUNT(*) AS disks,2 SUM(d.total_mb) AS total_mb,3 SUM(d.free_mb) AS free_mb4FROM v$asm_disk_stat d5JOIN v$asm_diskgroup_stat g6 ON g.group_number = d.group_number7WHERE g.name = 'DATA'8GROUP BY d.failgroup9ORDER BY d.failgroup;1SELECT d.failgroup, d.failgroup_type,2 COUNT(*) AS disks, SUM(d.total_mb) AS total_mb3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7GROUP BY d.failgroup, d.failgroup_type8ORDER BY d.failgroup_type, d.failgroup;1SELECT d.name, d.failgroup, d.failgroup_type,2 d.voting_file, d.path3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND d.voting_file = 'Y'8ORDER BY d.failgroup, d.name;1SELECT d.failgroup, d.mode_status,2 COUNT(*) AS disks3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND d.mode_status IN ('OFFLINE', 'SYNCING')8GROUP BY d.failgroup, d.mode_status9ORDER BY d.failgroup, d.mode_status;1SELECT d.failgroup, SUM(d.total_mb) AS raw_mb2FROM v$asm_disk_stat d3JOIN v$asm_diskgroup_stat g4 ON g.group_number = d.group_number5WHERE g.name = 'DATA'6AND d.failgroup_type = 'REGULAR'7GROUP BY d.failgroup8ORDER BY raw_mb DESC;1SELECT d.failgroup,2 SUM(d.total_mb) AS total_mb,3 SUM(d.free_mb) AS free_mb,4 ROUND(100 * SUM(d.free_mb)5 / NULLIF(SUM(d.total_mb), 0), 1) AS free_pct6FROM v$asm_disk_stat d7JOIN v$asm_diskgroup_stat g8 ON g.group_number = d.group_number9WHERE g.name = 'DATA'10AND d.failgroup_type = 'REGULAR'11GROUP BY d.failgroup12ORDER BY free_pct;1SELECT d.failgroup, d.name, d.preferred_read,2 d.path3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7ORDER BY d.failgroup, d.name;1SELECT f.type, f.redundancy,2 COUNT(*) AS files,3 ROUND(SUM(f.space) / 1024 / 1024) AS allocated_mb4FROM v$asm_file f5JOIN v$asm_diskgroup_stat g6 ON g.group_number = f.group_number7WHERE g.name = 'DATA'8GROUP BY f.type, f.redundancy9ORDER BY allocated_mb DESC;1SELECT f.file_number, f.incarnation,2 f.type, f.redundancy, f.remirror3FROM v$asm_file f4JOIN v$asm_diskgroup_stat g5 ON g.group_number = f.group_number6WHERE g.name = 'DATA'7AND g.type = 'FLEX'8AND f.remirror = 'Y'9ORDER BY f.file_number;1SELECT a.name, a.value, a.read_only2FROM v$asm_attribute a3JOIN v$asm_diskgroup_stat g4 ON g.group_number = a.group_number5WHERE g.name = 'DATA'6AND a.name IN ('disk_repair_time',7 'failgroup_repair_time')8ORDER BY a.name;1asmcmd du +DATA1asmcmd du +DATA/ORCL1asmcmd ls -s +DATA/ORCL/DATAFILE1# 非交互模式下须保护通配符,避免 shell 提前展开2asmcmd find --type CONTROLFILE +DATA/ORCL '*'1asmcmd lsof -G DATA1SELECT f.type, COUNT(*) AS files,2 ROUND(SUM(f.bytes) / 1024 / 1024) AS logical_mb,3 ROUND(SUM(f.space) / 1024 / 1024) AS allocated_mb4FROM v$asm_file f5JOIN v$asm_diskgroup_stat g6 ON g.group_number = f.group_number7WHERE g.name = 'DATA'8GROUP BY f.type9ORDER BY allocated_mb DESC;1SELECT f.file_number, f.incarnation,2 f.type, f.redundancy,3 ROUND(f.bytes / 1024 / 1024) AS logical_mb,4 ROUND(f.space / 1024 / 1024) AS allocated_mb5FROM v$asm_file f6JOIN v$asm_diskgroup_stat g7 ON g.group_number = f.group_number8WHERE g.name = 'DATA'9ORDER BY f.space DESC10FETCH FIRST 20 ROWS ONLY;1SELECT d.name, d.failgroup, d.path,2 d.total_mb, d.free_mb,3 ROUND(100 * d.free_mb4 / NULLIF(d.total_mb, 0), 1) AS free_pct5FROM v$asm_disk_stat d6JOIN v$asm_diskgroup_stat g7 ON g.group_number = d.group_number8WHERE g.name = 'DATA'9AND d.failgroup_type = 'REGULAR'10ORDER BY free_pct, d.name;1SELECT d.name, d.failgroup, d.path,2 d.total_mb, d.free_mb3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND d.failgroup_type = 'REGULAR'8AND d.free_mb < :disk_free_mb_limit9ORDER BY d.free_mb;1asmcmd lsod -G DATA1asmcmd iostat -G DATA 51asmcmd iostat --io -G DATA 51SELECT d.name, i.reads, i.writes,2 ROUND(i.bytes_read / 1024 / 1024, 2) AS read_mb,3 ROUND(i.bytes_written / 1024 / 1024, 2) AS write_mb,4 i.read_errs, i.write_errs, i.read_time, i.write_time5FROM v$asm_disk_iostat i6JOIN v$asm_disk_stat d7 ON d.group_number = i.group_number8 AND d.disk_number = i.disk_number9WHERE i.group_number =10 (SELECT group_number FROM v$asm_diskgroup_stat WHERE name = 'DATA')11ORDER BY i.read_errs + i.write_errs DESC,12 i.read_time + i.write_time DESC;1srvctl config asm -detail1adrci exec="show homes" | grep '^diag/asm/'1adrci exec="set homepath diag/asm/+asm/+ASM1; show alert -tail 100 -term"1SELECT i.dbname, i.instname, i.disk_number,2 i.reads, i.writes,3 ROUND(i.bytes_read / 1024 / 1024) AS read_mb,4 ROUND(i.bytes_written / 1024 / 1024) AS write_mb5FROM v$asm_disk_iostat i6JOIN v$asm_diskgroup_stat g7 ON g.group_number = i.group_number8WHERE g.name = 'DATA'9ORDER BY i.dbname, i.instname, i.disk_number;1SELECT i.dbname, i.instname, i.disk_number,2 i.read_errs, i.write_errs,3 i.read_timeout, i.write_timeout4FROM v$asm_disk_iostat i5JOIN v$asm_diskgroup_stat g6 ON g.group_number = i.group_number7WHERE g.name = 'DATA'8AND (i.read_errs + i.write_errs9 + i.read_timeout + i.write_timeout) > 010ORDER BY i.dbname, i.instname, i.disk_number;1SELECT d.name,2 ROUND(1000 * d.read_time / NULLIF(d.reads, 0), 2) AS read_ms,3 ROUND(1000 * d.write_time / NULLIF(d.writes, 0), 2) AS write_ms,4 d.reads, d.writes5FROM v$asm_disk_stat d6JOIN v$asm_diskgroup_stat g7 ON g.group_number = d.group_number8WHERE g.name = 'DATA'9AND d.failgroup_type = 'REGULAR'10ORDER BY read_ms DESC NULLS LAST;1SELECT d.name, d.path, d.mode_status, d.state,2 d.read_timeout, d.write_timeout,3 d.repair_timer4FROM v$asm_disk_stat d5JOIN v$asm_diskgroup_stat g6 ON g.group_number = d.group_number7WHERE g.name = 'DATA'8AND (d.read_timeout + d.write_timeout > 09 OR d.mode_status <> 'ONLINE')10ORDER BY d.mode_status, d.name;1asmcmd lsop1SELECT g.name, o.pass, o.state, o.power, o.actual2FROM v$asm_operation o3JOIN v$asm_diskgroup_stat g4 ON g.group_number = o.group_number5ORDER BY g.name, o.pass;1SELECT g.name, o.pass, o.state,2 o.power AS requested_power,3 o.actual AS allocated_power4FROM v$asm_operation o5JOIN v$asm_diskgroup_stat g6 ON g.group_number = o.group_number7WHERE g.name = 'DATA'8ORDER BY o.pass;1SELECT g.name, o.pass, o.state,2 o.est_work, o.est_rate, o.est_minutes3FROM v$asm_operation o4JOIN v$asm_diskgroup_stat g5 ON g.group_number = o.group_number6WHERE g.name = 'DATA'7ORDER BY o.pass;1SELECT g.name, o.pass, o.state, o.error_code2FROM v$asm_operation o3JOIN v$asm_diskgroup_stat g4 ON g.group_number = o.group_number5WHERE o.state = 'ERRS'6OR o.error_code IS NOT NULL7ORDER BY g.name, o.pass;1SELECT o.inst_id, g.name, o.pass, o.state,2 o.power, o.actual, o.est_minutes3FROM gv$asm_operation o4JOIN gv$asm_diskgroup_stat g5 ON g.inst_id = o.inst_id6 AND g.group_number = o.group_number7WHERE g.name = 'DATA'8ORDER BY o.inst_id, o.pass;1SELECT d.name, d.path, d.failgroup,2 d.state, d.mode_status, d.free_mb3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND d.state IN ('DROPPING', 'HUNG', 'FORCING')8ORDER BY d.state, d.name;1asmcmd lsdg -g DATA1SHOW PARAMETER asm_power_limit1asmcmd iostat -t --io -G DATA 51asmcmd lsattr -l -G DATA1asmcmd pwget --asm1asmcmd showpatches1SELECT name, type, allocation_unit_size,2 sector_size, logical_sector_size,3 block_size4FROM v$asm_diskgroup_stat5WHERE name = 'DATA';1asmcmd lstmpl -l -G DATA1SELECT t.name, t.redundancy, t.stripe,2 t.primary_region, t.mirror_region3FROM v$asm_template t4JOIN v$asm_diskgroup_stat g5 ON g.group_number = t.group_number6WHERE g.name = 'DATA'7AND t.name = 'DATAFILE';1SELECT t.name, t.redundancy, t.stripe, t.system2FROM v$asm_template t3JOIN v$asm_diskgroup_stat g4 ON g.group_number = t.group_number5WHERE g.name = 'DATA'6AND t.name IN ('CONTROLFILE', 'ONLINELOG', 'ARCHIVELOG')7ORDER BY t.name;1SELECT g.name AS diskgroup_name,2 f.name AS filegroup_name,3 f.client_type, f.client_name,4 f.quotagroup_number, f.used_quota_mb5FROM v$asm_filegroup f6JOIN v$asm_diskgroup_stat g7 ON g.group_number = f.group_number8WHERE g.name = 'DATA'9ORDER BY f.name;1SELECT c.db_name, c.instance_name,2 c.software_version, c.compatible_version3FROM v$asm_client c4JOIN v$asm_diskgroup_stat g5 ON g.group_number = c.group_number6WHERE g.name = 'DATA'7ORDER BY c.db_name, c.instance_name;1SELECT a.inst_id, g.name, a.name, a.value2FROM gv$asm_attribute a3JOIN gv$asm_diskgroup_stat g4 ON g.inst_id = a.inst_id5 AND g.group_number = a.group_number6WHERE g.name = 'DATA'7AND a.name IN ('compatible.asm', 'compatible.rdbms')8ORDER BY a.name, a.inst_id;1-- 在目标数据库 CDB$ROOT 或非 CDB 执行2SELECT file#, name, status3FROM v$datafile4WHERE name LIKE '+DATA/%'5ORDER BY file#;1-- 在目标数据库 CDB$ROOT 或非 CDB 执行2SELECT file#, name, status3FROM v$tempfile4WHERE name LIKE '+DATA/%'5ORDER BY file#;1-- 在目标数据库执行2SELECT name, status, is_recovery_dest_file3FROM v$controlfile4ORDER BY name;1-- 在目标数据库执行2SELECT group#, type, status, member3FROM v$logfile4WHERE member LIKE '+%'5ORDER BY group#, type, member;1-- 在目标数据库执行;按现场替换天数2SELECT thread#, sequence#, name, completion_time3FROM v$archived_log4WHERE name LIKE '+%'5AND completion_time >= SYSDATE - :days_back6ORDER BY completion_time DESC7FETCH FIRST 50 ROWS ONLY;1asmcmd lsof --dbname ORCL1# 非交互模式下保护通配符2asmcmd find --type BACKUPSET +DATA/ORCL '*'1SELECT a.name AS alias_name, a.system_created,2 f.file_number, f.incarnation, f.type,3 ROUND(f.bytes / 1024 / 1024) AS logical_mb4FROM v$asm_alias a5JOIN v$asm_file f6 ON f.group_number = a.group_number7 AND f.file_number = a.file_number8 AND f.incarnation = a.file_incarnation9JOIN v$asm_diskgroup_stat g10 ON g.group_number = f.group_number11WHERE g.name = 'DATA'12AND a.alias_directory = 'N'13ORDER BY f.file_number, a.name;1# 路径和块号须取自目标数据库的实际数据文件2asmcmd mapblk -l +DATA/ORCL/DATAFILE/USERS.259.123456789 101# 换成第 71—74 条确认过的现用路径2asmcmd ls -ls +DATA/ORCL/DATAFILE/USERS.259.1234567891asmcmd dsget1asmcmd lsdsk --candidate -k -p --discovery1asmcmd lsdsk -M1SELECT d.name, d.path, d.os_mb, d.total_mb,2 d.sector_size, d.logical_sector_size3FROM v$asm_disk d4WHERE d.header_status = 'CANDIDATE'5ORDER BY d.path;1SELECT name, type, total_mb, free_mb,2 required_mirror_free_mb, usable_file_mb,3 offline_disks4FROM v$asm_diskgroup_stat5WHERE name = 'DATA';1SELECT d.failgroup, COUNT(*) AS disks,2 SUM(d.total_mb) AS total_mb,3 SUM(d.free_mb) AS free_mb4FROM v$asm_disk_stat d5JOIN v$asm_diskgroup_stat g6 ON g.group_number = d.group_number7WHERE g.name = 'DATA'8AND d.failgroup_type = 'REGULAR'9GROUP BY d.failgroup10ORDER BY d.failgroup;1SELECT d.name, d.failgroup, d.path,2 d.header_status, d.mode_status, d.state3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND (d.mode_status <> 'ONLINE'8 OR d.state <> 'NORMAL')9ORDER BY d.failgroup, d.name;1SELECT d.name, d.path, d.failgroup,2 d.mode_status, d.repair_timer3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND d.mode_status = 'OFFLINE'8ORDER BY d.repair_timer, d.name;1SELECT c.inst_id, g.name,2 c.db_name, c.instance_name, c.status3FROM gv$asm_client c4JOIN gv$asm_diskgroup_stat g5 ON g.inst_id = c.inst_id6 AND g.group_number = c.group_number7WHERE g.name = 'DATA'8ORDER BY c.db_name, c.inst_id, c.instance_name;1-- 仅在 ASM 实例估算,不执行 DROP;盘名须替换2EXPLAIN WORK SET STATEMENT_ID='drop_data_0001'3FOR ALTER DISKGROUP DATA DROP DISK DATA_0001;4SELECT statement_id, timestamp, est_work5FROM v$asm_estimate6WHERE statement_id = 'drop_data_0001'7ORDER BY timestamp DESC;1asmcmd md_backup /var/tmp/asm-DATA-metadata.bak -G DATA1ALTER DISKGROUP DATA ADD FAILGROUP FG_NEW DISK2 '/dev/mapper/asm-data-new1' NAME DATA_NEW1;1SELECT d.name, d.path, d.header_status,2 d.mode_status, d.state, d.failgroup3FROM v$asm_disk_stat d4JOIN v$asm_diskgroup_stat g5 ON g.group_number = d.group_number6WHERE g.name = 'DATA'7AND d.name = 'DATA_NEW1';1ALTER DISKGROUP DATA DROP DISK DATA_0001;1asmcmd lsdsk -p --discovery /dev/mapper/asm-data-old11ALTER DISKGROUP DATA OFFLINE DISK DATA_00012 DROP AFTER 2h;1ALTER DISKGROUP DATA ONLINE DISK DATA_0001;1asmcmd rebal --modify 1 DATA1asmcmd chkdg DATA1SELECT g.inst_id, g.name, g.state, g.type,2 g.offline_disks, g.free_mb, g.usable_file_mb3FROM gv$asm_diskgroup_stat g4WHERE g.name = 'DATA'5ORDER BY g.inst_id;