备份恢复 & 迁移22 分钟阅读
达梦 SQL 性能诊断 100 条命令
达梦库里的慢 SQL,先分清是当下还在跑,还是刚才已经跑完。只看一条历史耗时,容易漏掉高频执行、解析、读页和计划变化。现场排查通常从会话和慢 SQL 清单入手,拿到 SQL_ID 与 EXEC_ID 后,再看执行历史和计划算子。
2026年9月16日阅读—点赞—收藏—
dba100damengscenario
100 条命令系列文章专栏
达梦库里的慢 SQL,先分清是当下还在跑,还是刚才已经跑完。只看一条历史耗时,容易漏掉高频执行、解析、读页和计划变化。现场排查通常从会话和慢 SQL 清单入手,拿到 SQL_ID 与 EXEC_ID 后,再看执行历史和计划算子。
达梦库里的慢 SQL,先分清是当下还在跑,还是刚才已经跑完。只看一条历史耗时,容易漏掉高频执行、解析、读页和计划变化。现场排查通常从会话和慢 SQL 清单入手,拿到 SQL_ID 与 EXEC_ID 后,再看执行历史和计划算子。
这里整理 DM8 常用的 SQL 性能诊断命令。遇到线上慢查询可以按顺序查,建议先收藏,需要时也方便把 SQL_ID 和结果转给同事一起判断。
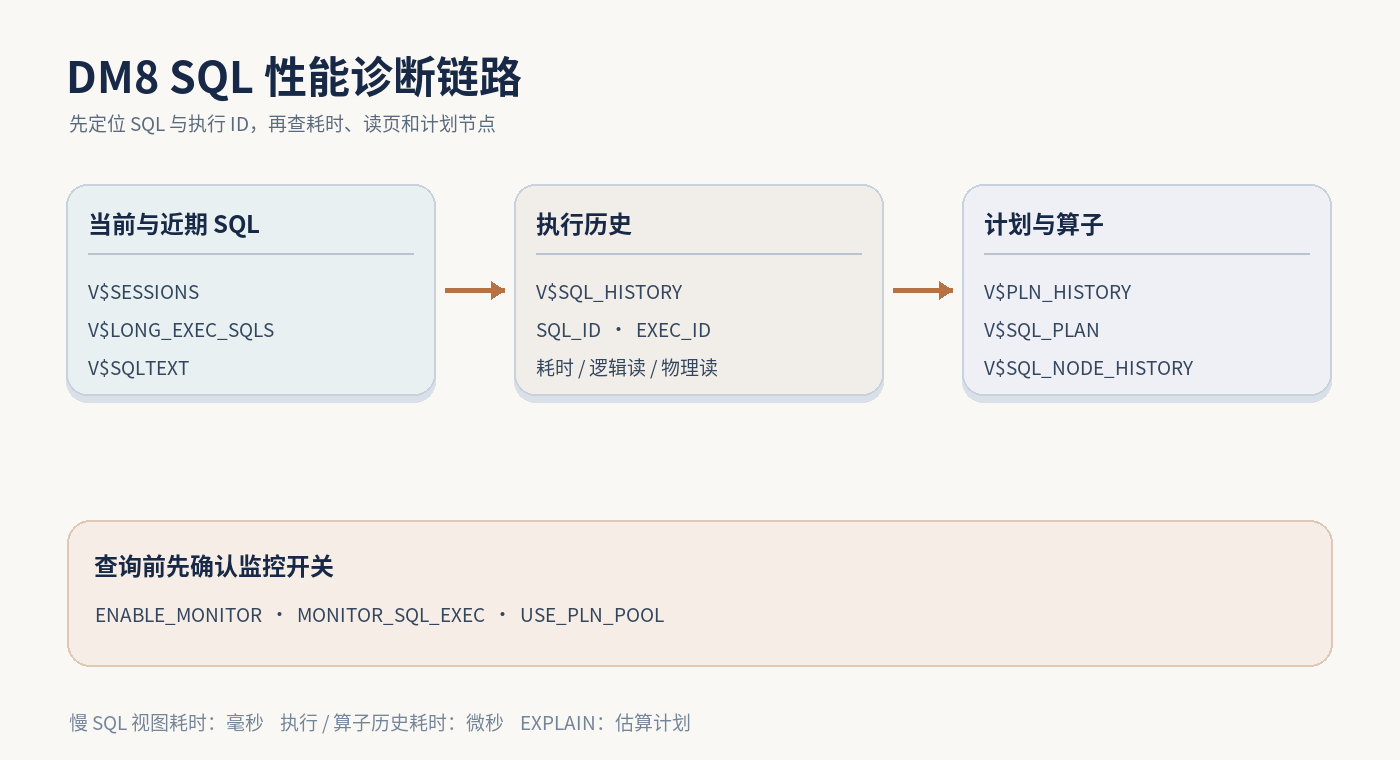 达梦 DM8 SQL 性能诊断链路示意图
示例用 DM8 单实例,SQL 在 DIsql 执行。部分历史视图需要开启监控,计划池也有自己的开关;视图为空时先核对配置,不要直接判断“没有慢 SQL”。下面的 :sql_id、:exec_id 和业务表名要换成现场值。
1SELECT SESS_ID, STATE, USER_NAME, TRX_ID, SQL_TEXT2FROM V$SESSIONS3WHERE STATE = 'ACTIVE'4ORDER BY SESS_ID;SQL_TEXT 只保留前 1000 个字符,长 SQL 要用 SQL_ID 继续找。活动状态说明会话正在工作,不能单凭这列认定它在消耗 CPU。
1SELECT SF_GET_LONG_TIME();这个值以毫秒计,默认是 1000 毫秒。先看阈值,再读慢 SQL 清单;阈值被调高时,几百毫秒的语句不会进入清单。
1SELECT SQL_ID, SESS_ID, EXEC_ID, SQL_TEXT,2 EXEC_TIME, FINISH_TIME3FROM V$LONG_EXEC_SQLS4ORDER BY EXEC_TIME DESC;需要 ENABLE_MONITOR=1。这里是最近保留的 n 条超阈值 SQL,不是全库长期历史;EXEC_TIME 为毫秒。DDL 等敏感语句不会进入此视图。
1SELECT SQL_ID, SQL_TEXT, N_RUNS,2 MIN_EXEC_TIME, MAX_EXEC_TIME, TOTAL_EXEC_TIME3FROM V$SYSTEM_LONG_EXEC_SQLS4ORDER BY TOTAL_EXEC_TIME DESC;单次最慢和累计最耗时不是一回事。这里看实例启动以来的聚合信息,仍受监控开关、慢 SQL 阈值和保留条数限制;耗时列为毫秒。
1SELECT SQL_ID, SQL_TEXT_ID, N_EXEC, SQL_TEXT2FROM V$SQLTEXT3WHERE SQL_NTH = 04ORDER BY N_EXEC DESC;SQL_NTH=0 取文本第一段。长 SQL 还会有后续分段,不能把第一段误当全文。N_EXEC 是缓存记录的执行次数,实例重启或缓存淘汰后不能当累计历史。
1SELECT SQL_ID, SESS_ID, EXEC_ID, START_TIME,2 TIME_USED, IS_OVER, N_LOGIC_READ, N_PHY_READ3FROM V$SQL_HISTORY4ORDER BY START_TIME DESC;需要 ENABLE_MONITOR=1。TIME_USED 是微秒,和第 3 条的毫秒不能直接比较。IS_OVER 用来区分已经结束和仍在执行的记录;读页量可以帮助判断慢在数据访问还是其他环节。
1SELECT SQL_ID, TOP_SQL_TEXT, SQL_PLAN2FROM V$PLN_HISTORY3WHERE SQL_ID = :sql_id;先确认 USE_PLN_POOL 不为 0。计划文本是 CLOB,较大的计划可能被截断;拿它和当前计划对照时,还要核对绑定值、统计信息和执行时间。
1SELECT SQL_ID, SQLSTR, PLN_TYPE, PHD_TIME2FROM V$SQL_PLAN3WHERE SQL_ID = :sql_id4ORDER BY PHD_TIME DESC;PHD_TIME 是计划生成时间。计划池只反映当前仍保留的内容,不能用“没有查到”证明历史上没有变更计划。
1EXPLAIN SELECT ORDER_ID, CUSTOMER_ID2FROM APP.ORDERS3WHERE CUSTOMER_ID = 10001;把表和条件换成真实 SQL,尽量保持绑定变量、谓词和连接方式一致。EXPLAIN 展示优化器的估算代价和行数;要核对实际耗时与算子行数,还需要执行历史或现场采样。
1SELECT SEQ_NO, EXEC_ID, TYPE$, N_ENTER,2 TIME_USED, MEM_USED, DISK_USED3FROM V$SQL_NODE_HISTORY4WHERE EXEC_ID = :exec_id5ORDER BY SEQ_NO;这个视图还要求 MONITOR_SQL_EXEC。TIME_USED 是微秒,MEM_USED 和 DISK_USED 以 KB 计。先看最耗时的节点,再对照计划里的序号和节点类型;不能只凭节点名称推断瓶颈。
1SELECT SESS_ID, USER_NAME, TRX_ID, STATE, CLNT_IP,2 DBMS_LOB.SUBSTR(SF_GET_SESSION_SQL(SESS_ID)) AS SQL_TEXT3FROM V$SESSIONS4WHERE STATE = 'ACTIVE'5 AND DBMS_LOB.SUBSTR(SF_GET_SESSION_SQL(SESS_ID)) LIKE '%ORDERS%';比 SQL_TEXT 列更适合取长 SQL。先确认 SQL 真的还在执行,再继续查等待。
1SELECT ID, WAIT_FOR_ID, WAIT_TIME, THRD_ID2FROM V$TRXWAIT3WHERE ID = :trx_id;WAIT_FOR_ID 是阻塞事务号。没有结果时还要检查字典锁和其他资源等待。
1SELECT SESS_ID, USER_NAME, STATE, TRX_ID,2 CLNT_IP, APPNAME, SQL_TEXT3FROM V$SESSIONS4WHERE TRX_ID = :wait_for_id;先联系业务确认是否忘记提交,再决定如何处理。不要因为会话空闲就直接关闭。
1SELECT *2FROM V$LOCK3WHERE BLOCKED = 1;适合补充 V$TRXWAIT 查不到的字典对象等待。记录表 ID、事务和锁模式。
1SELECT ID, NAME, SCHID, TYPE$2FROM SYS.SYSOBJECTS3WHERE ID = :table_id;把锁记录还原成业务对象,再判断阻塞影响范围。
1SELECT *2FROM V$TRX3ORDER BY START_TIME;字段会随版本变化,先看完整结果。重点识别长事务、未提交事务和异常状态。
1SELECT USER_NAME, COUNT(*) AS ACTIVE_SESSIONS2FROM V$SESSIONS3WHERE STATE = 'ACTIVE'4GROUP BY USER_NAME5ORDER BY ACTIVE_SESSIONS DESC;会话多不等于负载高,但可以快速锁定突增的业务账号。
1SELECT CLNT_IP, APPNAME, COUNT(*) AS SESSIONS2FROM V$SESSIONS3GROUP BY CLNT_IP, APPNAME4ORDER BY SESSIONS DESC;连接池配置异常时,客户端分布通常比 SQL 排名更早暴露问题。
1SELECT SESS_ID, SF_GET_SESSION_SQL(SESS_ID) AS FULL_SQL2FROM V$SESSIONS3WHERE SESS_ID = :sess_id;保存原始 SQL、绑定条件和时间,再做计划复现。
1CALL SP_CLOSE_SESSION(:sess_id);高风险操作。必须确认事务影响、回滚量和业务负责人同意,关闭后继续观察等待链。
1SELECT SQL_ID, SESS_ID, EXEC_ID, START_TIME,2 TIME_USED, N_LOGIC_READ, N_PHY_READ3FROM V$SQL_HISTORY4WHERE IS_OVER = 'N'5ORDER BY START_TIME;历史视图的进行中标记要和当前会话交叉验证,避免读到刷新时点差异。
1SELECT SQL_ID, EXEC_ID, TOP_SQL_TEXT,2 N_LOGIC_READ, N_PHY_READ, TIME_USED3FROM V$SQL_HISTORY4ORDER BY N_LOGIC_READ DESC5LIMIT 20;逻辑读高通常说明访问数据量大或计划低效,不等于磁盘读高。
1SELECT SQL_ID, EXEC_ID, TOP_SQL_TEXT,2 N_PHY_READ, N_LOGIC_READ, TIME_USED3FROM V$SQL_HISTORY4ORDER BY N_PHY_READ DESC5LIMIT 20;结合缓存命中、数据规模和执行频率判断,不能只优化一次冷缓存执行。
1SELECT SQL_ID, EXEC_ID, TOP_SQL_TEXT,2 BYTES_DYNAMIC_ALLOCED - BYTES_DYNAMIC_FREED AS NET_BYTES,3 TIME_USED4FROM V$SQL_HISTORY5ORDER BY NET_BYTES DESC6LIMIT 20;净分配只是线索;排序、哈希和返回大结果集都可能增加内存。
1SELECT SQL_ID, EXEC_ID, TOP_SQL_TEXT,2 HARD_PARSE_FLAG, START_TIME3FROM V$SQL_HISTORY4WHERE HARD_PARSE_FLAG = 25ORDER BY START_TIME DESC;大量硬解析要继续看 SQL 是否字面量变化、计划缓存是否频繁淘汰。
1SELECT SQL_ID, COUNT(*) AS EXECUTIONS,2 SUM(TIME_USED) AS TOTAL_US,3 AVG(TIME_USED) AS AVG_US,4 MAX(TIME_USED) AS MAX_US5FROM V$SQL_HISTORY6GROUP BY SQL_ID7ORDER BY TOTAL_US DESC8LIMIT 20;累计耗时适合找系统总负担,最大耗时适合找偶发尖峰。
1SELECT START_TIME, EXEC_ID, TIME_USED,2 N_LOGIC_READ, N_PHY_READ, AFFECTED_ROWS3FROM V$SQL_HISTORY4WHERE SQL_ID = :sql_id5ORDER BY START_TIME DESC;同一 SQL 耗时波动时,对照读页、影响行数、绑定值和并发情况。
1SELECT SQL_ID, MAX(N_EXEC) AS N_EXEC,2 MAX(SQL_TEXT) AS SQL_PREFIX3FROM V$SQLTEXT4GROUP BY SQL_ID5ORDER BY N_EXEC DESC6LIMIT 20;缓存统计会受淘汰和重启影响,只用于当前实例窗口。
1SELECT SQL_ID, SQL_NTH, SQL_TEXT2FROM V$SQLTEXT3WHERE SQL_ID = :sql_id4ORDER BY SQL_NTH;按 SQL_NTH 顺序拼接,不能只取第一段分析长 SQL。
1SELECT SQL_ID, SQL_TEXT, N_RUNS,2 ROUND(TOTAL_EXEC_TIME / NULLIF(N_RUNS,0), 2) AS AVG_MS,3 MAX_EXEC_TIME4FROM V$SYSTEM_LONG_EXEC_SQLS5ORDER BY AVG_MS DESC;平均慢和偶发慢要分开治理,先确认样本执行次数足够。
1SELECT TYPE$, NAME, DESC_CONTENT, VERSION2FROM V$SQL_NODE_NAME3ORDER BY TYPE$;先把算子编号映射为名称和说明,再解读节点历史。
1SELECT H.SEQ_NO, N.NAME, N.DESC_CONTENT,2 H.N_ENTER, H.TIME_USED, H.MEM_USED, H.DISK_USED3FROM V$SQL_NODE_HISTORY H4JOIN V$SQL_NODE_NAME N ON N.TYPE$ = H.TYPE$5WHERE H.EXEC_ID = :exec_id6ORDER BY H.SEQ_NO;按耗时、进入次数、内存和磁盘综合判断,不能只看算子名字。
1SELECT SEQ_NO, TYPE$, N_ENTER, TIME_USED,2 MEM_USED, DISK_USED3FROM V$SQL_NODE_HISTORY4WHERE EXEC_ID = :exec_id5ORDER BY TIME_USED DESC;算子耗时可能包含子节点时间,排名用于缩小范围,不宜直接相加。
1SELECT SEQ_NO, TYPE$, TIME_USED, DISK_USED, MEM_USED2FROM V$SQL_NODE_HISTORY3WHERE EXEC_ID = :exec_id4ORDER BY DISK_USED DESC;排序或哈希算子大量落盘时,再检查临时空间、内存配置和数据量估算。
1SELECT SEQ_NO, TYPE$, N_ENTER, TIME_USED2FROM V$SQL_NODE_HISTORY3WHERE EXEC_ID = :exec_id4ORDER BY N_ENTER DESC;嵌套循环内表被反复访问时,进入次数通常会明显升高。
1SELECT SQL_ID, SQLSTR, PLN_TYPE, PHD_TIME2FROM V$SQL_PLAN3ORDER BY PHD_TIME DESC;只代表仍在计划池中的内容。计划池关闭或淘汰后不会保留。
1SELECT SQL_ID, COUNT(*) AS PLAN_COUNT,2 MIN(PHD_TIME) AS FIRST_PLAN,3 MAX(PHD_TIME) AS LAST_PLAN4FROM V$SQL_PLAN5GROUP BY SQL_ID6HAVING COUNT(*) > 17ORDER BY PLAN_COUNT DESC;计划多不一定异常,要结合绑定值、统计信息和计划类型解释。
1SELECT SQL_ID, TOP_SQL_TEXT, SQL_PLAN2FROM V$PLN_HISTORY3ORDER BY SQL_ID;计划文本可能较大,导出时注意客户端 CLOB 显示长度。
1SELECT *2FROM V$COSTPARA;这些值参与代价估算。除非有正式调优依据,不要为一条 SQL 修改全局代价模型。
1SELECT SQL_ID, PHASE_FLAG, OPTIMIZE_CLASS,2 OPT_DESCRIPTION_CN, INI_PARA3FROM V$SQL_PARSE_HISTORY4WHERE SQL_ID = :sql_id5ORDER BY SEQ_NO;需要同时开启 ENABLE_MONITOR 和 MONITOR_SQL_PARSE。视图为空先查开关。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'ENABLE_MONITOR';关闭时多个历史视图为空,不能据此判断系统没有慢 SQL。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'MONITOR_SQL_EXEC';算子历史有额外开销,应按诊断窗口和版本建议使用。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'MONITOR_SQL_PARSE';只在需要分析优化过程时开启,并记录启停时间。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'USE_PLN_POOL';值为 0 时不使用计划池,相关视图可能无内容。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'LONG_EXEC_SQLS_CNT';保留条数过小会很快覆盖现场,故障发生后应及时导出。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'FIRST_ROWS';该参数影响优化目标。分页和全量批处理对首行响应的需求不同。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'PARALLEL_POLICY';确认是关闭、自动还是手动并行,再解释计划中的并行算子。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'MAX_PARALLEL_DEGREE';并行度不能超过并行工作线程配置。并行并非越高越快。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'PARALLEL_THRD_NUM';这是静态资源上限。修改前评估全库并发,而不是只看单条大查询。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DDL_WAIT_TIME';DDL 超时不一定是 SQL 计划差,先查字典对象锁和阻塞事务。
1SELECT DBMS_STATS.TABLE_STATS_SHOW('APP', 'ORDERS');没有统计信息时结果可能为空。先确认对象名和模式,再判断是否需要收集。
1SELECT DBMS_STATS.COLUMN_STATS_SHOW('APP', 'ORDERS', 'CUSTOMER_ID');选择率估算异常时,重点看列基数、空值和数据分布是否仍符合实际。
1SELECT DBMS_STATS.INDEX_STATS_SHOW('APP', 'IDX_ORDERS_CUSTOMER');索引存在不等于优化器会选它。统计信息、谓词和回表成本都会影响计划。
1CALL DBMS_STATS.GATHER_TABLE_STATS('APP', 'ORDERS');写操作,会更新优化器统计信息并可能改变后续执行计划。应在低峰执行并保留原计划。
1CALL DBMS_STATS.GATHER_INDEX_STATS('APP', 'IDX_ORDERS_CUSTOMER');适合索引数据变化明显而表统计仍可用的场景。执行后重新生成目标 SQL 的计划。
1CALL DBMS_STATS.GATHER_SCHEMA_STATS('APP');影响范围较大,可能触发多条 SQL 计划变化。生产环境需要窗口和回退方案。
1STAT 30 ON APP.ORDERS (CUSTOMER_ID);采样能降低大表统计开销,但可能漏掉倾斜。百分比要按数据量和分布选择。
1CALL SP_TAB_INDEX_STAT_INIT('APP', 'ORDERS');会为表上所有索引生成统计信息。执行前确认当前计划基线和业务低峰。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'AUTO_STAT_OBJ';确认当前是否使用自动收集以及收集对象范围,再决定是否手工补采。
1SELECT *2FROM SYS.SYSSTATTABLEIDU3WHERE TABLEID = :table_id;用于判断收集后表的增删改量和是否发生过 TRUNCATE。字段以现场版本为准。
1SELECT COLUMN_NAME, DATA_TYPE, DATA_LENGTH,2 NULLABLE, DATA_DEFAULT3FROM USER_TAB_COLUMNS4WHERE TABLE_NAME = 'ORDERS'5ORDER BY COLUMN_ID;谓词存在隐式类型转换时,索引可能无法正常使用。先核对列类型和绑定类型。
1SELECT INDEX_NAME, INDEX_TYPE, UNIQUENESS, STATUS2FROM USER_INDEXES3WHERE TABLE_NAME = 'ORDERS'4ORDER BY INDEX_NAME;索引状态正常只是前提,还要检查列顺序和实际谓词。
1SELECT INDEX_NAME, COLUMN_POSITION, COLUMN_NAME, DESCEND2FROM USER_IND_COLUMNS3WHERE TABLE_NAME = 'ORDERS'4ORDER BY INDEX_NAME, COLUMN_POSITION;联合索引能否利用,关键看前导列、等值条件和范围条件的位置。
1SELECT INDEX_NAME, LISTAGG(COLUMN_NAME, ',')2 WITHIN GROUP (ORDER BY COLUMN_POSITION) AS COLS3FROM USER_IND_COLUMNS4WHERE TABLE_NAME = 'ORDERS'5GROUP BY INDEX_NAME6ORDER BY COLS;结果用于人工比较索引前缀,不要仅凭列串相似就删除索引。
1SELECT SEGMENT_NAME, SEGMENT_TYPE,2 ROUND(BYTES / 1024 / 1024, 2) AS MB3FROM USER_SEGMENTS4WHERE SEGMENT_NAME IN ('ORDERS', 'IDX_ORDERS_CUSTOMER')5ORDER BY BYTES DESC;大索引会增加缓存和维护成本,但空间大本身不代表无用。
1SELECT TABLE_NAME, PARTITION_NAME, PARTITION_POSITION,2 TABLESPACE_NAME3FROM USER_TAB_PARTITIONS4WHERE TABLE_NAME = 'ORDERS'5ORDER BY PARTITION_POSITION;计划没有分区裁剪时,先检查谓词是否直接作用在分区键上。
1SELECT INDEX_NAME, PARTITION_NAME, STATUS2FROM USER_IND_PARTITIONS3WHERE INDEX_NAME = 'IDX_ORDERS_DATE'4ORDER BY PARTITION_POSITION;局部分区索引某个分区异常,可能只影响部分日期范围的计划。
1SELECT CONSTRAINT_NAME, CONSTRAINT_TYPE, INDEX_NAME, STATUS2FROM USER_CONSTRAINTS3WHERE TABLE_NAME = 'ORDERS'4ORDER BY CONSTRAINT_TYPE, CONSTRAINT_NAME;删除或重建索引前先确认是否承担主键、唯一约束功能。
1SELECT OBJECT_NAME, OBJECT_TYPE, STATUS,2 CREATED, LAST_DDL_TIME3FROM USER_OBJECTS4WHERE OBJECT_NAME IN ('ORDERS','IDX_ORDERS_CUSTOMER');计划突变时,对照对象 DDL、统计信息和应用上线时间。
1SELECT INDEX_NAME, STATUS2FROM USER_INDEXES3WHERE TABLE_NAME = 'ORDERS'4 AND STATUS <> 'VALID';修复前先确认失效原因和业务窗口,不要在高峰直接重建大索引。
1SELECT TABLESPACE_NAME, FILE_NAME, BYTES, STATUS2FROM DBA_DATA_FILES3WHERE TABLESPACE_NAME = 'TEMP';字段和临时空间实现随版本配置不同,先核对现场实际表空间名。
1SELECT *2FROM V$MEM_POOL;先看完整字段和各池使用情况,再按版本文档解释,避免套用其他数据库的内存术语。
1SELECT *2FROM V$THRDWAIT;等待事件要结合线程类型和持续时间看。单次快照只说明采样瞬间。
1SELECT *2FROM V$THRDWAIT_HISTORY3ORDER BY START_TIME DESC;历史视图有保留上限,故障后及时导出。字段以现场版本为准。
1SELECT *2FROM V$DEADLOCK_HISTORY3ORDER BY OCCUR_TIME DESC;死锁与普通长等待不同,应还原参与事务和 SQL 的访问顺序。
1SELECT *2FROM V$RUNTIME_ERR_HISTORY3ORDER BY OCCUR_TIME DESC;SQL 变慢伴随错误时,先确认是否有内存、临时空间或对象异常。
1SELECT *2FROM V$PRE_RETURN_HISTORY3ORDER BY START_TIME DESC;大结果集会消耗网络、客户端和服务端资源,优化不能只盯执行计划。
1SELECT COUNT(*) AS SESSION_COUNT2FROM V$SESSIONS;与正常时段基线比较。连接数异常增长可能先拖慢解析和调度。
1SELECT COUNT(*) AS TRX_COUNT2FROM V$TRX;事务数和会话数一起看,区分连接堆积与真正的事务堆积。
1SELECT COUNT(*) AS WAITING_TRX2FROM V$TRXWAIT;持续增长说明阻塞链没有释放,应立即定位 WAIT_FOR_ID。
1mpstat -P ALL 1 5看整体饱和还是单核热点。SQL 串行执行时总 CPU 不高也可能卡在单核。
1vmstat 1 10重点看 r、si/so、wa。持续换页会让 SQL 延迟大幅抖动。
1iostat -x 1 10结合 await、队列和利用率判断 I/O 压力,不要只看吞吐量。
1pidstat -p $(pgrep -n dmserver) 1 10确认瓶颈是否集中在 dmserver,并与慢 SQL 时间窗对齐。
1top -H -p $(pgrep -n dmserver)高 CPU 线程要结合数据库线程视图和日志分析,不能直接杀线程。
1free -hLinux 的 available 比单看 free 更有参考价值,同时检查 swap 使用。
1df -h数据盘、日志盘和临时目录空间不足都可能拖慢或中断 SQL。
1sar -n DEV 1 10客户端等待高而数据库执行时间正常时,要排查网络与结果集传输。
1uptime负载值需结合 CPU 核数、运行队列和 I/O 等待解释。
1grep -E 'ERROR|FATAL' /dm/dmdbms/log/dm_DMSERVER_$(date +%Y%m)*.log | tail -100把错误时间与 SQL 历史、系统监控放在同一时间线上。
1EXPLAIN SELECT ORDER_ID, CUSTOMER_ID2FROM APP.ORDERS3WHERE CUSTOMER_ID = 10001;使用与问题现场一致的谓词和绑定值,比较访问路径与估算行数。
1SELECT START_TIME, EXEC_ID, TIME_USED,2 N_LOGIC_READ, N_PHY_READ3FROM V$SQL_HISTORY4WHERE SQL_ID = :sql_id5ORDER BY START_TIME DESC6LIMIT 10;至少比较多次执行,避免把缓存预热当成优化收益。
1SELECT EXEC_ID, TYPE$, SUM(TIME_USED) AS TIME_US,2 SUM(MEM_USED) AS MEM_KB, SUM(DISK_USED) AS DISK_KB3FROM V$SQL_NODE_HISTORY4WHERE EXEC_ID IN (:before_exec_id, :after_exec_id)5GROUP BY EXEC_ID, TYPE$6ORDER BY TYPE$, EXEC_ID;计划结构改变时还要按节点语义比较,不能只按序号对齐。
1SELECT EXEC_ID, TIME_USED, N_LOGIC_READ, N_PHY_READ,2 AFFECTED_ROWS3FROM V$SQL_HISTORY4WHERE EXEC_ID IN (:before_exec_id, :after_exec_id)5ORDER BY EXEC_ID;结果集行数必须一致,否则耗时和读页量不可直接比较。
1SELECT *2FROM V$TRXWAIT;计划优化后仍慢时,重新排除阻塞,防止把并发问题归给 SQL 文本。
1SELECT *2FROM V$LOCK3WHERE BLOCKED = 1;空结果与事务等待一起判断,避免漏掉字典对象锁。
1SELECT SQL_ID, PLN_TYPE, PHD_TIME, SQLSTR2FROM V$SQL_PLAN3WHERE SQL_ID = :sql_id4ORDER BY PHD_TIME DESC;确认测试使用的是新计划,而不是仍在执行缓存中的旧计划。
1SELECT SQL_ID, COUNT(*) AS EXECUTIONS,2 MIN(TIME_USED) AS MIN_US,3 AVG(TIME_USED) AS AVG_US,4 MAX(TIME_USED) AS MAX_US,5 SUM(N_LOGIC_READ) AS LOGICAL_READS6FROM V$SQL_HISTORY7WHERE SQL_ID = :sql_id8GROUP BY SQL_ID;摘要应注明采样起止时间、业务量和版本,避免脱离上下文比较。
1SELECT *2FROM V$VERSION;计划行为与补丁版本有关,诊断记录必须包含完整版本号。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME IN ('ENABLE_MONITOR','MONITOR_SQL_EXEC',4 'MONITOR_SQL_PARSE','USE_PLN_POOL',5 'FIRST_ROWS','PARALLEL_POLICY',6 'MAX_PARALLEL_DEGREE')7ORDER BY PARA_NAME;把参数、计划、执行历史和主机采样一起留档,才能复盘这次优化是否真正有效。
达梦 SQL 调优先判断语句是否真的在执行,再排除事务等待和字典锁。确认是 SQL 本身后,用 SQL_ID、EXEC_ID 把执行历史、计划和算子串起来,最后检查统计信息、索引和主机资源。只看一张 EXPLAIN,通常不够解释线上为什么慢。
建议把常用 SQL_ID、业务模式名和监控开关整理成现场版本。发生性能抖动时,先留证据再改参数或统计信息。
更多数据库运维内容可在 ORA100 · DBA100 查看:
微信里搜索小程序 「三笠的百令册」,也可以继续查看这个系列。
 ORA100 DBA100